把 1998 年的英国电视游戏节目《Who Wants to Be a Millionaire》搬进课灵的全过程复盘——技术复刻不难,AI 出题才是真正的门槛。
在课灵上复刻《谁想成为百万富翁》游戏
这是一篇开发随笔。记录我最近把《Who Wants to Be a Millionaire》(谁想成为百万富翁)这个 1998 年的英国电视游戏节目搬进课灵的全过程。重心不在产品功能介绍,而在过程中那些踩过的坑、做过的取舍、以及几个让我自己意外的小发现。
一、为什么是"百万富翁"
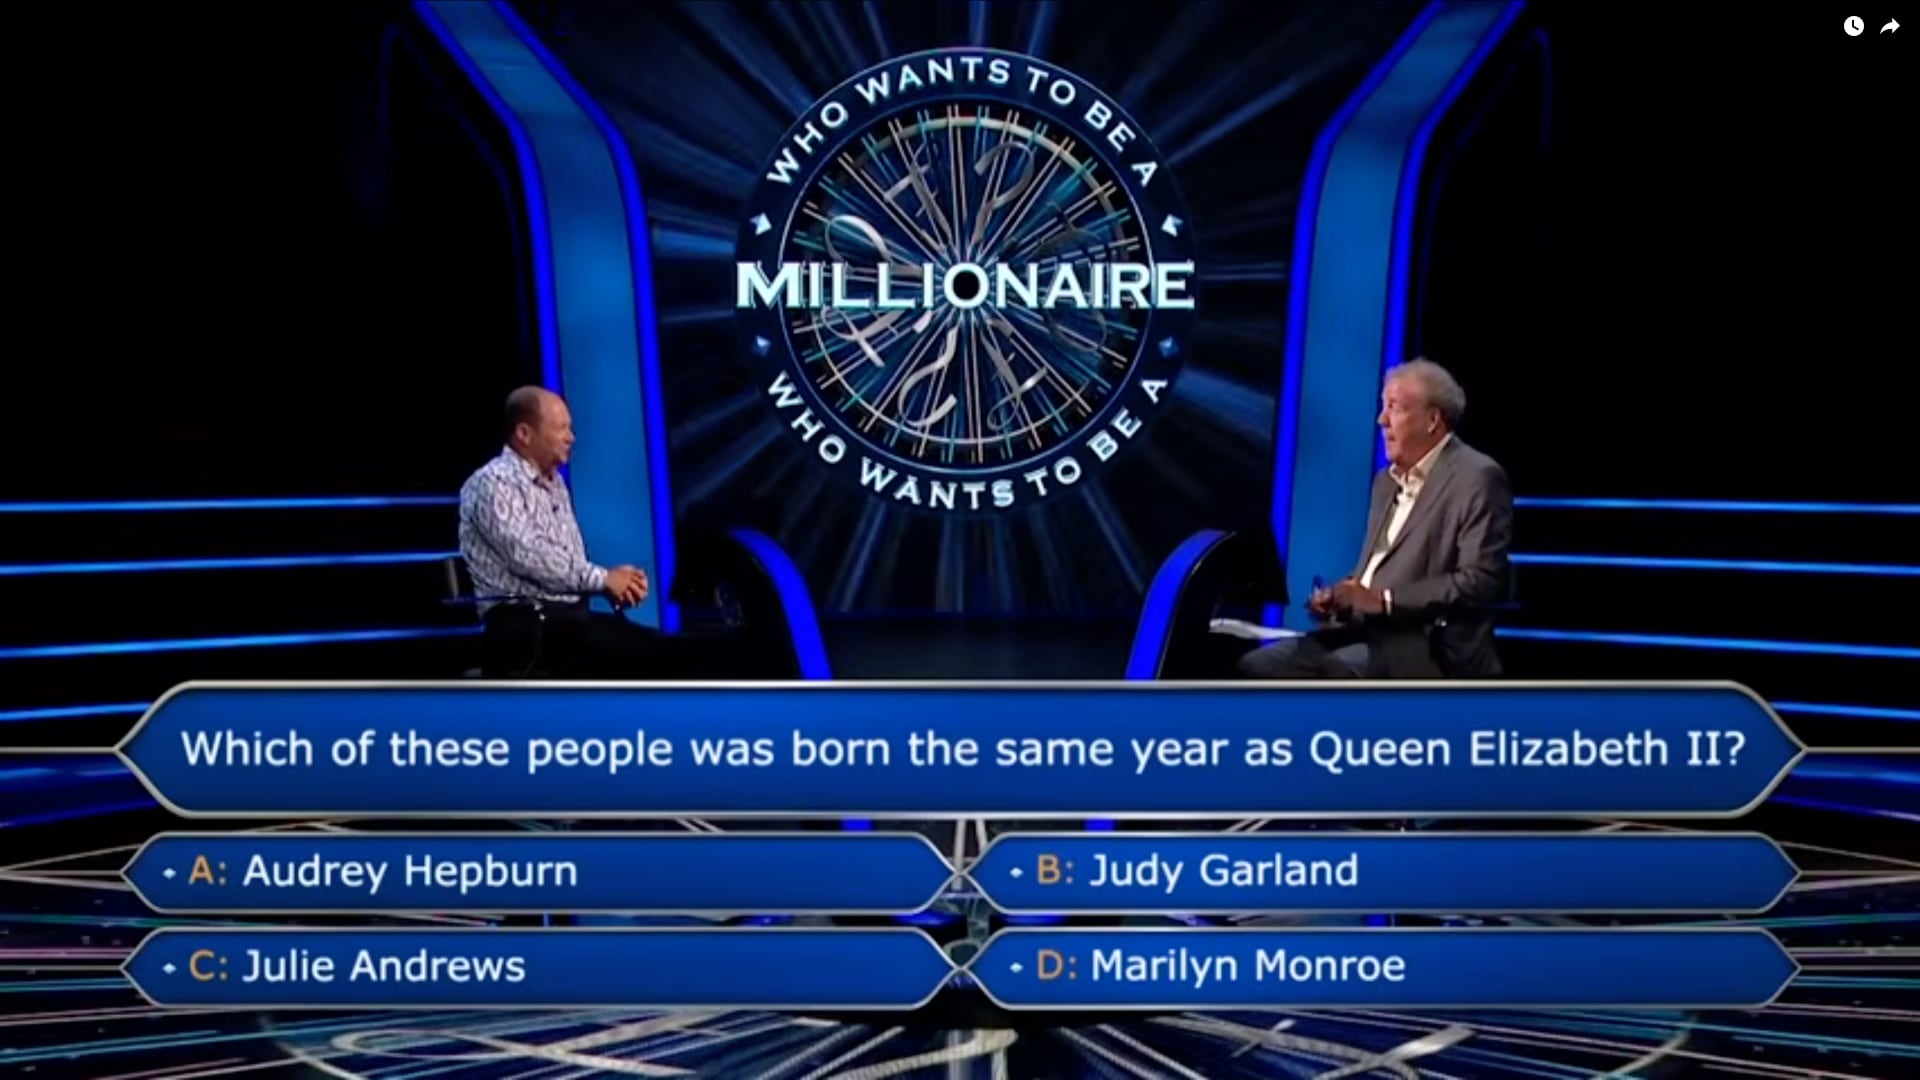
《Who Wants to Be a Millionaire》——是由英国独立电视台制作的一款电视游戏知识问答节目,15 道题,每题 4 个选项,难度递增,答错出局,达到安全线可以拿保底奖金,阅读百度百科《百万富翁》了解详细内容。
这个节目 1998 年首播,到今天还在播。它能活 27 年,本身就不寻常。我后来想明白了为什么——它把’答对题’包装成了一场小型的英雄之旅。
(顺便提一下:国内能连播 27 年的节目,我掰着手指数了数,除了春晚就没几个了。知识竞技这种"硬内容"能跑这么久,本身就是件值得琢磨的事。)
具体说,它的结构值得拆一拆:
- 即时反馈:选完答案立刻知道对错。行为主义学习理论最基本的强化循环。
- 难度阶梯:从常识到专业层层递进。暗合维果茨基的"最近发展区"——你够一够就能到,但下一题总会要你多走一步。
- 风险决策:见好就收,还是赌一把?这种"该不该继续"的判断本身就是高阶思维训练。
- 求助系统:打电话、问观众。本质是训练"你知道谁知道"——元认知的经典问题。
我在课灵中复刻了这个游戏,技术上用的是一款现成的 HTML5 游戏引擎,背景、角色、按钮、音效全部内置,渲染效果相当到位。引擎跑起来只用了半天。
真正难的是出题。
二、15 道题,人类出题者的噩梦
让我们面对现实:出一套好的百万富翁题目是相当困难的。
你需要的不是 15 个随机问题,而是一条有讲究的难度曲线。Q1 要简单到让人产生"我能行"的错觉,Q15 要难到让大家都要查一下。中间每一级都是一个小小的心理博弈——上一题给你信心,下一题就让你自我怀疑。
而且每道题需要 4 个选项:1 个正确答案 + 3 个干扰项。干扰项不是随便写的——它们必须看起来"有可能是对的",但又经不起推敲。这本质上是在模拟认知冲突:让学习者在几个貌似合理的答案之间做判断。
我们的用户大多是教师和课程设计者。他们懂内容,但不是题库专家。手动输入 15 题 × (1 题干 + 4 选项) = 75 个文本框,难度递增全靠感觉,干扰项质量参差不齐。
所以很自然地,我们把目光转向了 AI。
三、AI 出题:第一次翻车
第一次测试很简单——给 AI 一个主题,让它返回 15 道题。
结果令人失望。
AI 确实生成了 15 道题,但问题很多:难度几乎一样,区分度极低。同一个领域内反复问"第一个是什么"“最大的是哪个"“作者是谁”。干扰项要么太明显(“中国的首都是?A. 北京 B. 月亮 C. 火星 D. 太阳”),要么根本不合理。
这说明一个核心问题:AI 不理解什么叫"难”。
对人类来说,“Q15 应该比 Q1 难得多"是一个直觉判断。但对大语言模型来说,“难"是一个相当模糊的概念。它会默认把自己训练数据中最常出现的问题当作"正常的”,把稍微少见一点的当作"难的”——这和人类对难度的感知完全不同。
我自己盯了半小时 AI 的输出,才意识到问题出在更深一层:我们根本没告诉 AI 一个"难"的客观标准。我说"难一点",但凭什么"难"?是文字更长?是概念更冷门?还是需要跨领域推理?
于是我们开始系统性地思考:什么让一个问题变得"难"?
四、用 Bloom 分类法给 AI 一个"难度坐标系"
教育领域有一个经典框架叫 Bloom 认知分类法,它把认知过程分为六个层次:
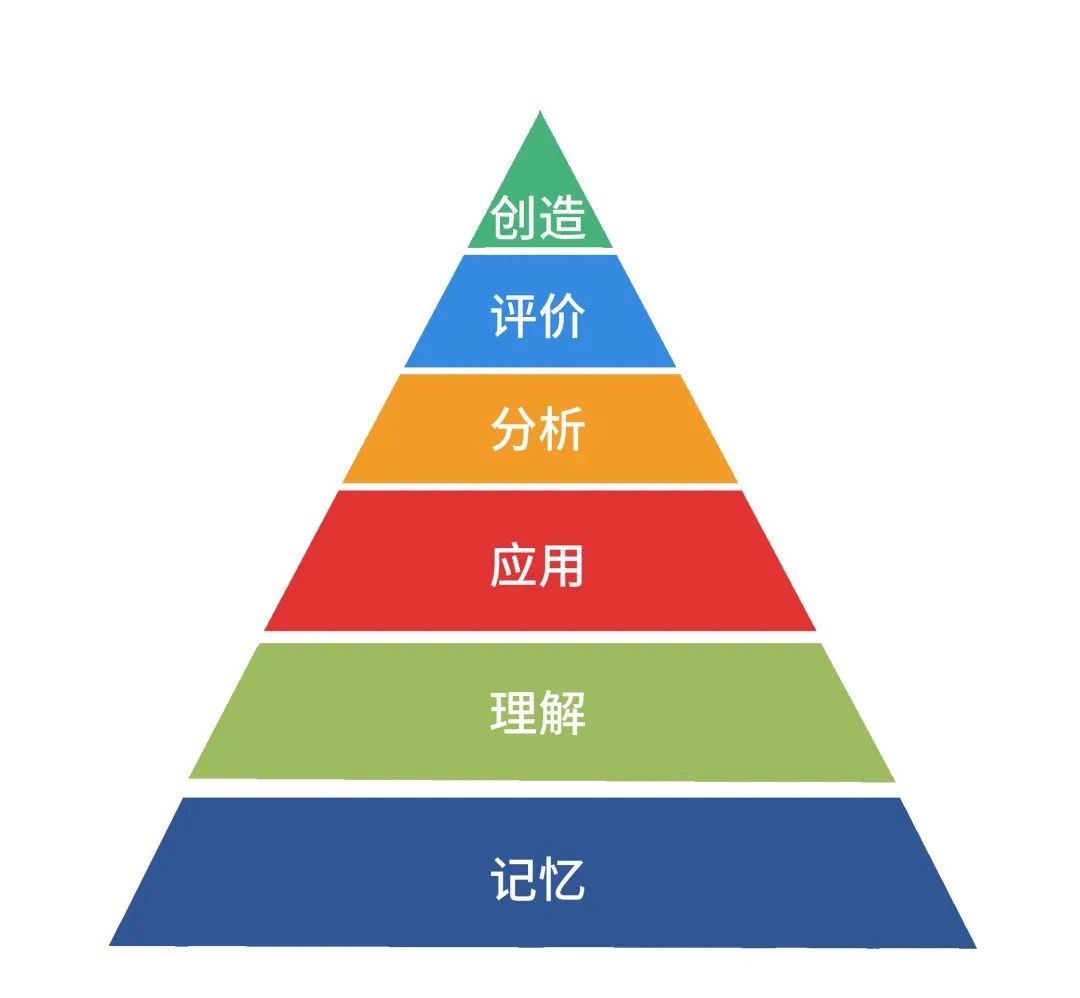
| 层次 | 认知活动 | 示例问题格式 |
|---|---|---|
| 记忆 | 回忆事实 | “是谁、是什么、哪一年” |
| 理解 | 解释概念 | “用自己的话解释…” |
| 应用 | 使用知识 | “如何用 X 解决 Y” |
| 分析 | 拆解关系 | “…与…的根本区别是什么” |
| 评价 | 做出判断 | “下列哪个观点最合理” |
| 创造 | 生成新事物 | “设计一个方案…” |
Bloom 分类法给了我们一个可量化的"难度坐标系"。但我们最初的做法是把它变成一个用户可以选择的难度滑块:入门、基础、进阶、专业、专家,五选一。
这带来一个逻辑上的矛盾:如果用户选了"入门",Q1 到 Q15 都是入门级——那 Q15 也太简单了。如果用户选了"专家",Q1 就是学术争论——那还有什么"热身"可言?真实的百万富翁游戏,Q1 偏容易,Q15 偏难。难度不在"整体档位",而在曲线的斜率。
很快我意识到我们一直在做错一件事——试图让"难度"成为一个用户可调的旋钮,但它其实应该是游戏本身的属性。
所以我们做了一个关键决定:移除难度选择器,把难度曲线直接写在游戏设计里。
现在,每一套题都有固定的 Bloom 进阶路径:
| 题号 | Bloom 层次 | 格式要求 |
|---|---|---|
| Q1-Q2 | 记忆 | “是什么/谁是/哪个”。最基础的事实。让人轻松入场。 |
| Q3-Q5 | 记忆+理解 | 课本级别,允许 1 个"为什么"。明显比 Q1-Q2 难。 |
| Q6-Q9 | 应用+分析 | 必须用"为什么"“如何影响"“区别是什么”。每题都要涉及因果关系或比较。 |
| Q10-Q12 | 分析+评价 | “主要原因"“如何评价"“根据…理论"“根本差异”。禁止一切"是什么"格式。 |
| Q13-Q15 | 评价 | “学界争论"“哪个证据最能反驳"“如何理解…在…中的作用”。Q15 必须最难。 |
这个设计的妙处在于:用户不再需要选择难度。 他们只需要输入主题——比如"中国近代史"或"分子生物学基础”——AI 自动在主题内按 Bloom 层次爬坡。Q1 是入门级的常识入口,Q15 站到该主题里比较深的认知层次。
效果令人满意。Q1 现在稳定在"中国的首都是哪"这种水平,而 Q15 则是"哪个证据最能反驳’李白是胡人’这个假说”——需要评价证据质量,而不是回忆事实。中间每一段都有比较明显的认知跳跃。
但真正的突破来自"禁止行为清单”。我们发现,告诉 AI 什么不能做,比告诉它做什么更有效。每个题目块都有自己的禁区:
- Q6-Q9:禁止纯事实回忆。禁止"是什么/谁是/哪一年”
- Q10-Q12:禁止一切"是什么/谁/哪一年/第一个/最大的”。禁止纯定义。每题必须分析或评价
- Q13-Q15:禁止一切简单回忆。如果非专业人士能答对,重写。干扰项必须代表真实学术立场
这种"负面约束"比正面描述更好用。AI 很难理解"让问题更难一点”,但它清楚地知道"不能做"的是什么。
五、不止是出题:用户体验的"最后一公里"
AI 出题再聪明,也会出现"幻觉"——把杜甫的诗说成李白的,把明朝的事安在宋朝头上。所以我们设计了一套让用户能够轻松把关的交互:
1. 预览优先,不直接填入
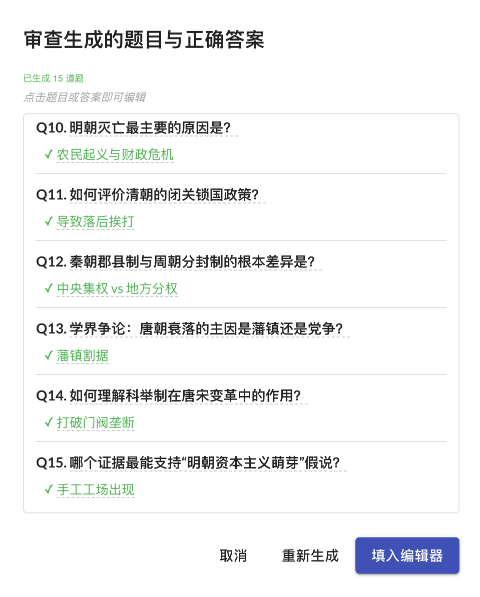
生成后不直接覆盖编辑器。而是弹出一个预览窗口,15 道题的题目和正确答案一目了然。用户可以先审阅,满意了再填入。
2. 只展示正确答案
我们刻意隐藏了干扰项,预览中只显示题目和正确答案。这是基于认知负荷理论:审核 15 道题已经够累了,如果再让用户检查 45 个干扰项的质量,他们只会跳过去直接点"保存"。
3. 点击即编辑
预览中的每个题目和答案都是可直接编辑的——点一下变输入框,回车保存。同时有字数计数器(题目 45 字、答案 12 字),防止文字太长破坏游戏 UI。
4. 一键重新生成
不满意?点"重新生成",相同参数再调一次 AI。
六、从复刻到创作
回顾整个过程,值得记一下的发现是:技术复刻很简单,内容创作才是真正的门槛。
把百万富翁的游戏引擎跑起来,半天。把出题体验打磨到可用,两天。而这两天里大部分时间不是在写代码,而是在思考三个问题——“什么让问题变难"“用户如何信任 AI 生成的内容"“如何降低把关的认知成本”。
让我意外的一个发现是:一个游戏的设计约束,比 AI 的能力更重要。 我们最初试图让用户选择难度等级,但这创造了一个两难局面——入门级的 Q15 太容易,专家级的 Q1 太难。直到我们意识到真正的百万富翁游戏根本不是"选难度”,而是"固定难度曲线”——Q1 偏友善,Q15 偏残酷——一切才豁然开朗。把这条曲线固化在规则里,比任何复杂的参数都有效。
Bloom 认知分类法给了我们一个可复用的坐标系,在多个领域都能用的范例。无论是中国历史、分子生物学、还是流行音乐,AI 都能沿着同样的认知阶梯生成从"入门"到"评价"的问题。
但这离完美还很远。AI 偶尔还会在 Q10-Q12 段偷偷塞入"哪个时期"这种纯回忆题。干扰项的质量在 Q13-Q15 段上仍有提升空间。可行的方向是让多个 AI Agent 互相校验——一个出题,一个评价难度,一个检查格式合规。那将是下一个阶段的事。
七、写给同样在折腾 AI 出题的你
如果你也在做类似的事,下面几条是我这段时间里反复验证过的:
第一,别让 AI 选难度,把难度定在规则里。
第二,告诉 AI 什么不能做,比告诉它做什么更有效。
第三,审核体验比生成质量更影响留存。让用户能 30 秒看完 15 道题,比让 AI 把 15 道题生成到 100 分更重要。
《谁想成为百万富翁》这个游戏功能现已在课灵中推出了,欢迎来课灵创建你自己的《谁想成为百万富翁》知识竞答游戏。如果你觉得这个游戏形式有意思,或者你在 AI 出题这件事上有想法,请来课灵社区和我们聊聊。